
Octávio Chaves
O Cérebro Congelado: Como a Inteligência Artificial Realmente “Pensa” e Lembra
 Jornal Democrata, edição 1941 de 26 de setembro de 2026
Basta digitar uma pergunta na tela para receber, em segundos, uma resposta impecavelmente articulada. A fluidez da conversa é tão convincente que a mente humana, sempre inclinada a encontrar intenção e consciência onde vê linguagem, cai facilmente na ilusão de que há alguém do outro lado — um ser digital que raciocina, pondera e lembra.
Para quem atua ou estuda tecnologia, no entanto, desmontar essa mística é um imperativo profissional. Compreender como os Grandes Modelos de Linguagem (LLMs) operam por baixo do capô não é apenas desvendar uma curiosidade técnica; é a única forma de entender por que essas ferramentas alternam entre a genialidade aparente e erros elementares.
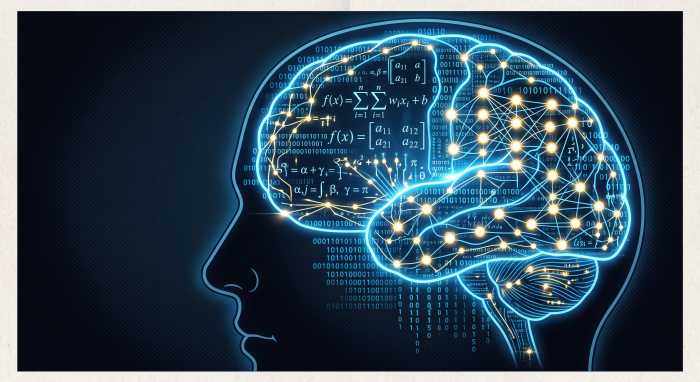
A verdade desconfortável e fascinante é que a inteligência artificial generativa não pensa. Ela calcula. E sua memória opera por princípios completamente distintos da biologia humana.
O “pensamento” nada mais é do que inferência probabilística
Quando um modelo de linguagem responde a um comando, não existe reflexão, intenção prévia ou deliberação ética. O que ocorre é um processo matemático chamado inferência.
O modelo analisa o texto de entrada (transformado em vetores numéricos através de representações matemáticas) e calcula qual é o próximo pedaço de palavra mais provável de aparecer naquela sequência. É um sistema monumental de predição estatística treinado para completar padrões.
Se o resultado soa coerente e inteligente, é porque a máquina foi alimentada com petabytes de linguagem humana, refinando bilhões de conexões numéricas até que suas predições refletissem a própria estrutura do nosso raciocínio. Mas o motor dessa engrenagem não é a consciência: é probabilidade vetorial de altíssima precisão.
A anatomia da memória em um modelo de linguagem
Para os técnicos em informática, a melhor metáfora para entender as “lembranças” da IA é olhar para a arquitetura tradicional de hardware e software: a divisão entre armazenamento permanente congelado, memória volátil de trabalho e barramentos de entrada/saída.
1. Memória Estática (Paramétrica): O binário compilado
A memória estática corresponde aos pesos sinápticos da rede neural. Durante a fase de pré-treinamento, o algoritmo analisa vastas bibliotecas de texto e ajusta os valores matemáticos (parâmetros) que definem a força das conexões entre neurônios artificiais.
Uma vez concluído esse processo, o modelo é congelado.
Essa memória funciona como uma memória ROM ou um software compilado: o modelo não aprende nada novo durante o uso diário. Se um evento aconteceu ontem e não estava no conjunto original de dados, o modelo simplesmente desconhece sua existência por via própria. Além disso, se uma informação gravada nesses parâmetros for incompleta, a rede neural tentará preencher a lacuna com base em padrões de plausibilidade estatística, gerando as famosas alucinações.
2. Janela de Contexto: A memória RAM da sessão
Quando abrimos uma tela de chat e mantemos um diálogo contínuo, a IA parece lembrar do que dissemos cinco minutos antes. Essa não é uma memória permanente, mas sim a janela de contexto.
Ela funciona exatamente como a memória RAM: volátil e limitada por capacidade de buffer (medida em tokens). O modelo não “guarda” a conversa no cérebro; a cada nova mensagem enviada, a aplicação empacota todo o histórico anterior e o submete novamente ao algoritmo como se fosse uma nova consulta. Quando a sessão é encerrada ou o limite de tokens da janela é atingido, essas informações são descartadas.
3. Memória Externa e RAG: O barramento para a internet
Como um cérebro digital estático pode se manter útil em um mundo em constante transformação? Por meio de mecanismos de recuperação externa, conhecidos pela sigla RAG (Retrieval-Augmented Generation).
Nessa arquitetura, a IA ganha a capacidade de consultar APIs, bancos de dados vetoriais externos ou motores de busca na web. Antes de responder, o sistema detecta a necessidade de fatos atualizados, realiza uma pesquisa em tempo real, lê os resultados e injeta esses dados frescos diretamente na janela de contexto da máquina. A rede neural usa sua lógica gramatical estática apenas para sintetizar e redigir o que acabou de “ler” da fonte externa.
4. Memória Persistente: O arquivo de configurações
Por fim, as plataformas modernas utilizam perfis persistentes de usuário — equivalentes a arquivos de configuração (.ini ou .json). Trata-se de um banco de dados relacional simples, em paralelo ao modelo, que armazena preferências, correções de estilo e instruções duradouras do operador, reaplicando-as a cada nova conversa para dar a sensação de continuidade pessoal.
O perigo da confiança cega
Compreender essa separação estrutural é vital para o futuro da informação e do trabalho técnico. Quando um usuário leigo presume que a IA tem onisciência, ele comete o erro de tomar predições probabilísticas da memória paramétrica como verdades factuais incontestáveis.
A IA só se torna verdadeiramente confiável e produtiva quando o operador humano atua como engenheiro e auditor: sabendo calibrar prompts, impondo fontes de validação externa e compreendendo que, por trás da prosa impecável, opera apenas um conjunto extraordinário de matrizes matemáticas.
A máquina entrega o cálculo; o discernimento e a responsabilidade sobre o conteúdo continuarão sendo, sem substitutos à vista, um trabalho humano.
Octávio Augusto A. Chaves é formado em Técnico em Informática pela ETEC e trabalha com produção audiovisual.
*Imagens criadas com I.A.


COMENTÁRIOS